(示意图:把 N 个独立会话的带宽汇聚成一份)
〇、太长不看
- 校园网常见的形态是「账号 × 设备会话」限速:一台设备 = 一个会话 = 一份带宽配额(下文记为 C)。
- 认证系统原生支持同一账号多台设备在线(无感认证白名单 / 多会话并存),而限速桶是会话级的——N 个互不共享的会话,理论上能拿到约 N 倍单会话带宽。
- 聚合的正确粒度是连接 / 流,绝不是包;稳态下行基本遵循 50n Mbps——n 个在用桶就是 n 倍单桶额度(单桶稳态约 47~50 Mbps),而单连接下载恒等于一个桶。
- 收益的前提是健壮性:会话保活、断线自愈、腿级熔断、白名单巡检缺一不可,否则聚合会悄无声息退化成单会话。
- 研究已从「能跑」推进到「好管」:原理文档 + 全占位符模板 + 单账号双桶最小配方 + 多桶聚合控制台(状态可视化、分流熔断摘腿 / 放腿、桶启用停用)。
- 全部研究仅在自有权属 / 获授权的账号与设备上完成,并以脱敏形态开源:只承载方法论与通用实现套路,不包含任何真实标识。
研究文档已开源:campus-bandwidth-aggregation。本文是它的入口叙事,详细原理、模板与验证方法都在仓库里。
文中所有速率均为相对倍数 / 量级区间的示意,不指向任何真实网络、账号或设备。
一、问题:一台设备只有一份带宽
学校宿舍的网络按「账号 × 会话」限速。所谓会话,就是一次认证成功后在线的那个「在线单元」:一台设备认证一次就是一个会话,接入网关给每个会话单独下发限速策略——换句话说,每个会话是一个带宽桶。
于是单台设备的带宽天花板 = 单会话上限 C:下载文件峰值就在 C 附近;多开几个下载器也只是把 C 均分,总量上不去。
大多数人到此为止。但有个问题特别诱人:这个 C 到底挂在账号上,还是会话上?
- 如果挂在账号上:同一账号开 10 个会话也只有一份带宽,聚合没有意义;
- 如果挂在会话上:认证系统又恰好允许同一账号多点在线(无感白名单、多会话并存),那 N 个会话就是 N 份互不共享的带宽。「多设备并行 + 出口合并」,不就能得到接近 N×C 的等效带宽吗?
答案要靠实验说话。这篇博客记录的就是:从这个问题出发,到原理验证、工程实现、健壮性设计,再到把整套研究脱敏开源的完整过程。
二、研究方法:先观测,后建模
动手之前先回答第一个问题:限速的计量单位到底是什么。这一步做不干净,后面所有工程都是空中楼阁。我沉淀了一套可复用的观测方法论:
(1)多源交叉验证选对端。 至少选 2~3 个相互独立的测速源:一个国际测速平台的官方 CLI 节点、一个国内软件分发 CDN、一个常用应用的安装包 CDN。判读口径是:三个源测出的合计都封顶在同一水平 → 限速发生在本侧网络设备,与对端无关。注意 CDN 的「单连接限流」是常见陷阱——有的 CDN 单条 TCP 连接只能到会话上限的三分之一左右,这不是网络限速。
(2)单连接 vs 多连接对照。 关键实验是同一对端下「单连接 vs 8 路并行」:
- 单连接能爬满 ≈1.0C → 每连接没有独立配额;
- 8 路并行合计也封顶在 ≈0.96~1.0C,且各条均分 → 桶在会话层,多开只是均分。
「多开会把同一份总量均分」这个现象本身,就是「限速按会话生效」的第一条证据。
(3)时长与采样。 单次测量至少持续 10~15 秒,让 TCP 慢启动充分爬升;逐秒采样吞吐曲线看形态——平滑爬升后稳定封顶更像固定承诺速率(CIR)整形,先冲一波再回落说明存在突发(PIR)。同一场景至少 3 次取样,取平台段的中位数。
(4)上下行分开测,退出代理。 校园网套餐上下行通常独立且不对称(下行约为上行的 5 倍档位,数值逐测稳定)→ 固定档位的承诺速率,而非动态竞争。测试期间退出一切代理 / VPN 类客户端,否则测到的是代理链路而不是校园网。
(5)有线 / 无线对照补测。 同一设备的两个介质口(有线 + 无线)分别独立认证 = 两个独立会话。先各测单会话(档位应一致 → 限速与介质无关),再同时并发看合计——这是「会话级限速」最直接的证据。
证据链:为什么我能确定「限速挂在会话上」
| # | 观测 | 推理 |
|---|---|---|
| ① | 单连接 ≈1.0C,8 路并行合计 ≈0.96~1.0C 且各条均分 | 限速不是每连接,而是每会话一个总量桶 |
| ② | 换对端只改变单流可达高度:一个对端单流 ≈0.3C(CDN 限流),另一个 ≈1.0C | 上限由本侧网络设备决定,与对端无关 |
| ③ | 有线 + 无线双会话并发合计 ≈1.98C(各自单会话均 ≈1.0C) | 若按账号聚合应仍为 1.0C——实测翻倍,实锤按会话独立计量 |
| ④ | 上行 ≈0.2C、下行 ≈1.0C,比例稳定 | 固定档位(CIR)而非浮动竞争 |
| ⑤ | 多源多次采样平台值稳定不抖动 | 会话层整形器(CIR≈PIR),而非共享竞争 |
| ⑥ | 实测平台值与账号套餐档位一致(下行 C、上行 C/5) | 限速来源 = 账号套餐,认证成功后按会话执行 |
推论一句话:认证权限与限速策略都挂在会话上。「并发设备数」决定能开几个会话,「限速档位」决定每个会话跑多快——两者是正交的两个维度。 这是后面所有工作的地基。
三、模型:会话即「桶」,稳态下行 ≈ 50n Mbps
地基建好后,等效带宽模型自然浮现:
等效带宽上限 ≈ N × C(N 个互不共享的在线会话同时满额时)——在本环境里单桶 C ≈ 50 Mbps,于是稳态下行 ≈ 50n Mbps。
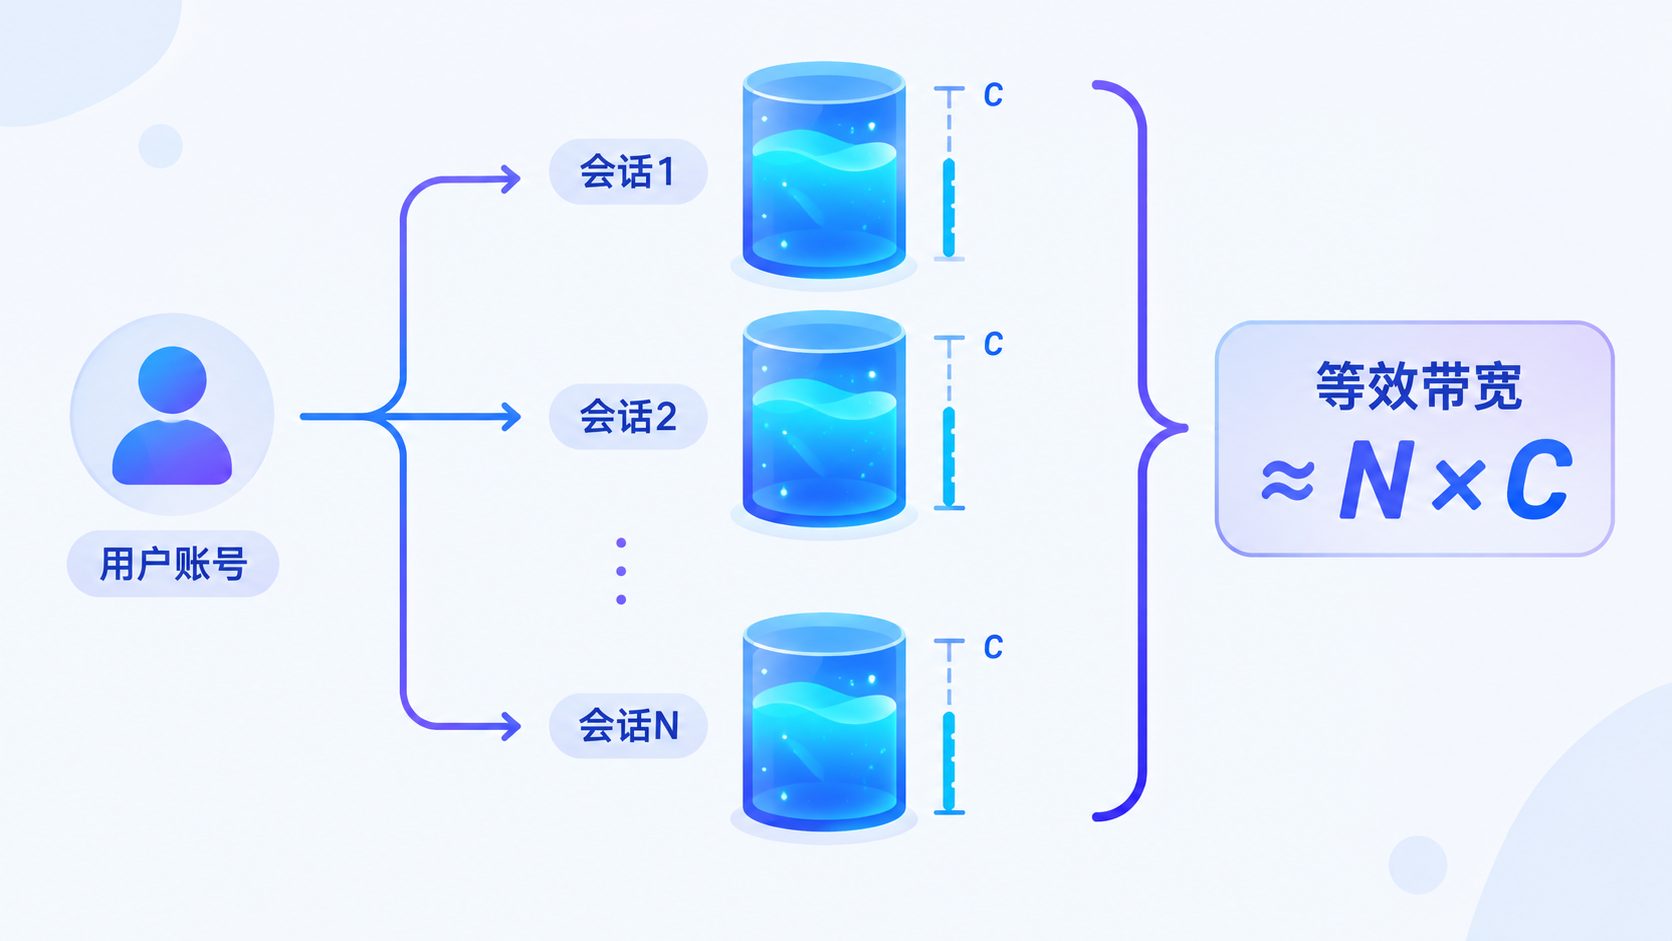
(模型示意:每个会话一个独立限速桶,N 个桶并行 ≈ N×C)
「聚合」的含义也就清楚了:不是把单条连接变快,而是把同一份任务(下载、浏览、流媒体)的连接 / 分片分布到多个桶,让每个桶都按自己的 C 满负荷工作,再在出口侧合并。
实测下来这条规律非常干净:50n Mbps(n = 实际在用的桶数)——单桶稳态实测约 47~50 Mbps,n=2 约 100、n=3 约 150、n=4 约 200 Mbps,三个点都有实测支撑(四桶时逐桶直测 46.8–47.2 Mbps,四条腿高度一致)。用多线程下载器(建议 4–8 线程,越多越接近上限)就能把这 N 份额度吃满;而单连接下载永远只等于一个桶(约 50 Mbps),这正是「感觉聚合没生效」最常见的原因。
两条使用前提比数值本身更重要:
- 它是基线参照,不是达标判据:读数明显低于 50n 时,先怀疑源端 / 服务端限速(不少镜像站会对同一出口限流),再往桶侧查——某条腿其实没在用、被真机上线顶掉、或半死腿丢包;
- 峰值不等于容量:短窗口(不足 1 秒)能跑到远超 50n 的突发值(PIR 额度),真实下载场景只认稳态平台值。
模型只是上限,现实有四个钳制:
- 物理链路:稳态上限就是「桶数 × 单桶额度」——n 个桶要有 n × 50M 的链路余量才能兑现(本环境四桶稳态合计约两百 Mbps 档位,≈ 4 × 单桶,与 50n 吻合);链路 / 墙口不够宽时,桶再多也吃不满;
- 对端能力:CDN 单连接限流、对端连接数限制——对端不给流量,桶满不上去;验收聚合必须多连接并发测速,单连接永远等于单桶;
- 分流均匀性(哈希碰撞):最关键,见下一节;
- 会话生命周期与隧道单桶:会话会被回收、会被顶替;经加密隧道转发的流量在出口处表现为「一条 socket」,只能走一个桶——境外流量天然吃不到多桶红利,把多桶能力留给国内直连流量是现实选择。
四、工程实现:两条路径,一个原则
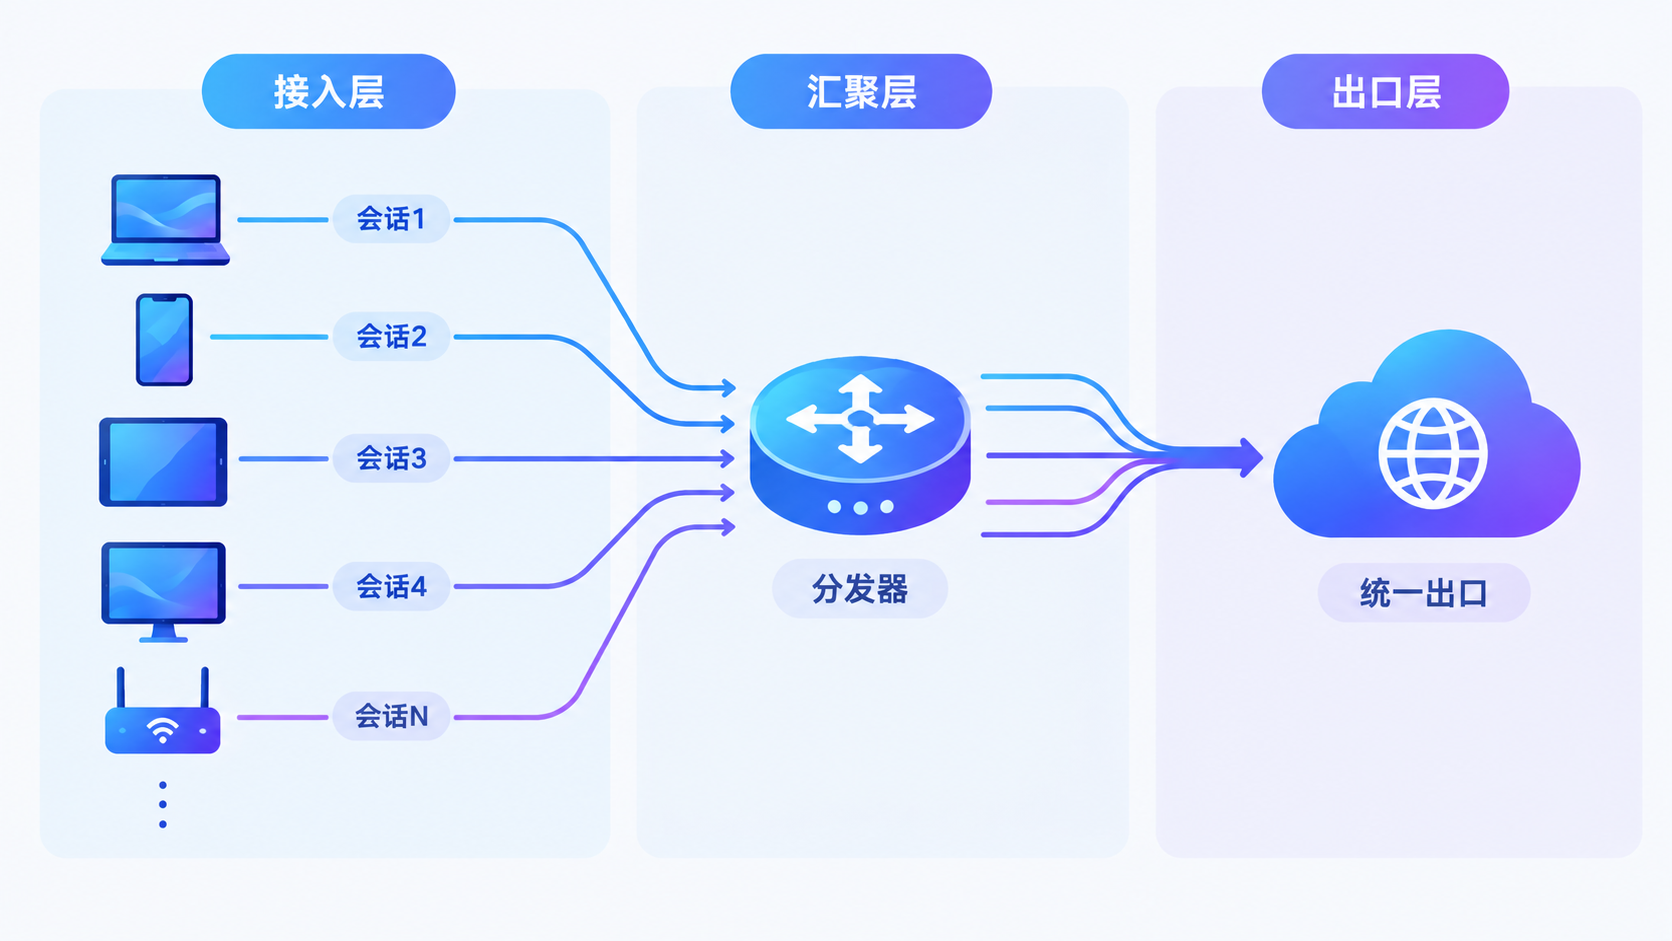
(三层架构:接入层建立 N 个会话 → 汇聚层按流分发 → 出口层呈现统一出口)
一个原则:分发粒度必须是「连接 / 流」,不是「包」
如果按包轮询,把一条 TCP 流的包散到两条路径:两条路径时延 / 带宽不同 → 对端收到乱序段 → 触发重复 ACK → 发送端快速重传、拥塞窗口减半 → 吞吐塌缩到接近最差路径,严重时重传风暴甚至连接重置。而且每个会话有独立公网出口,同一连接从两个公网地址交替发出,会直接破坏 NAT 绑定与对端连接状态。
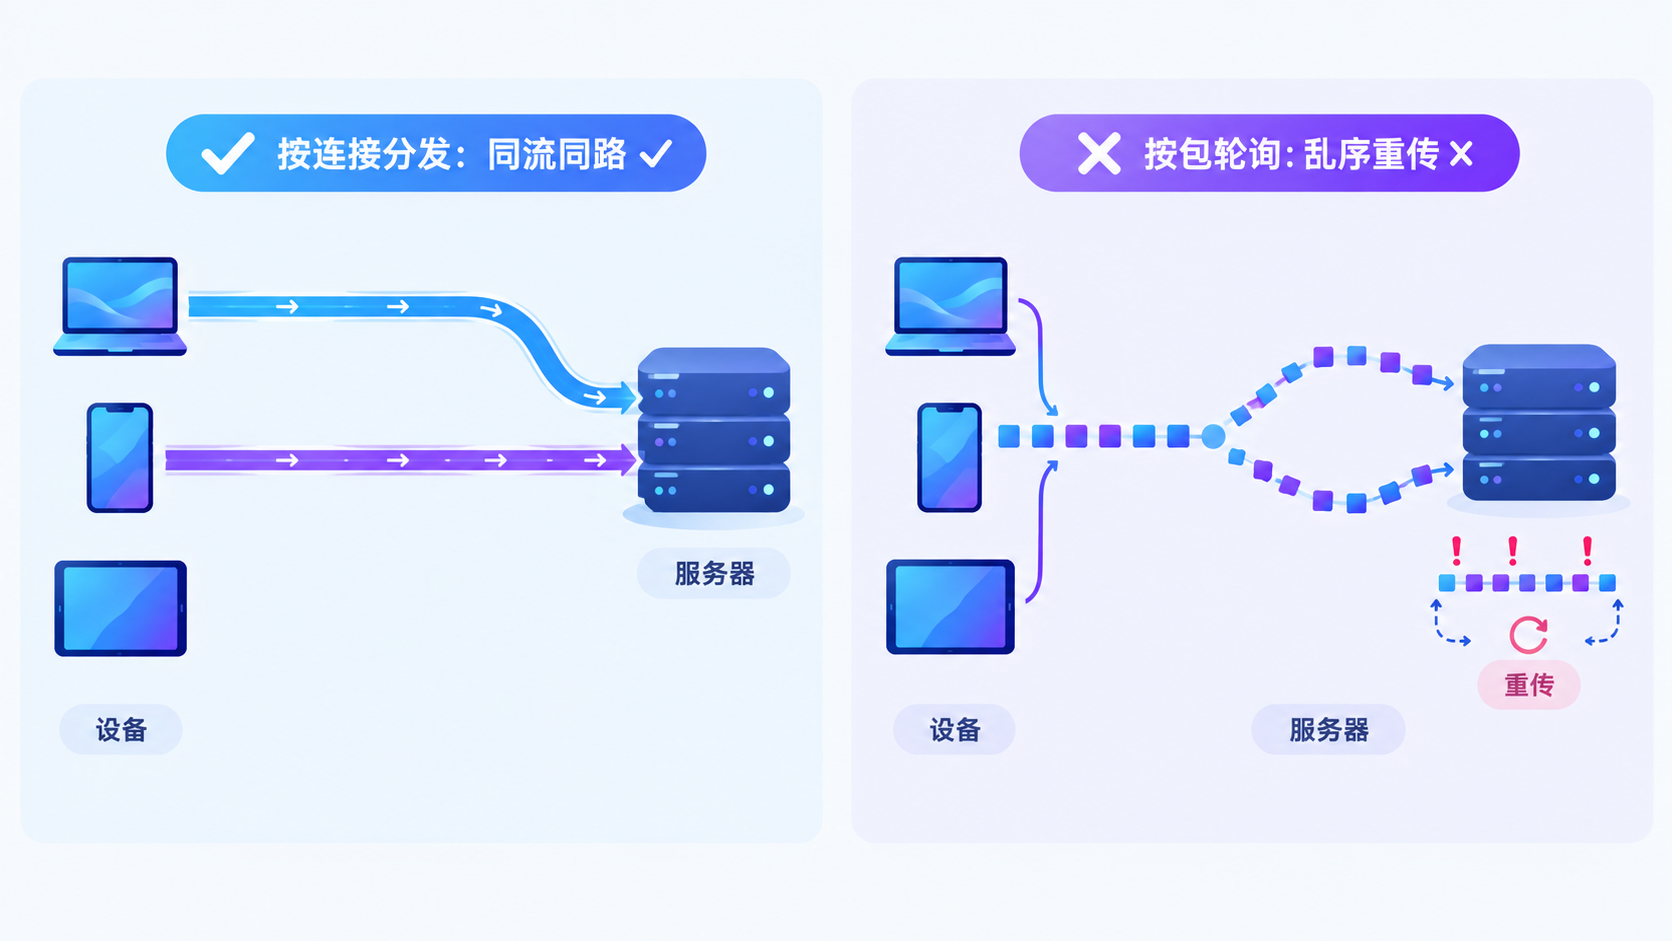
(左:按连接分发、同流同路;右:按包轮询导致乱序重传)
正确做法是按连接分发:新建连接时选定一条会话,此后该连接的所有包恒走该会话(同流同路)。代价是单条连接的带宽 ≤ 单会话上限——这是 TCP 语义决定的硬边界,靠多连接应用(网页多资源、流媒体分片、多线程下载器、应用商店)天然摊平。
若目标是让单条长连接也翻倍,只能走数据包级绑定 + 远端中继按序重组,这依赖你自己无法控制的远程基础设施。自建、无中继的聚合只能做到连接级——本次研究所有方案都建立在这个边界内。
路径一:网关形态(multipath / mwan3)
解决「一个网段内多台设备,如何共享多条会话出口」:软路由上每根 WAN 接口 = 一条会话,默认路由多 nexthop 按流哈希选路,同一流恒走同一接口。
最容易踩的坑是哈希字段:只按源 / 目的 IP(L3)哈希时,大量连接指向同一 CDN 边缘 IP,会全部命中同一条路径——实测出现过一腿满载、另一腿近乎为零的极端失衡(两腿流量比 1:300+);Linux 下开启 L4 哈希(net.ipv4.fib_multipath_hash_policy=1,含端口)后立即恢复近 1:1。「配了聚合却没提速」,九成是这个问题。
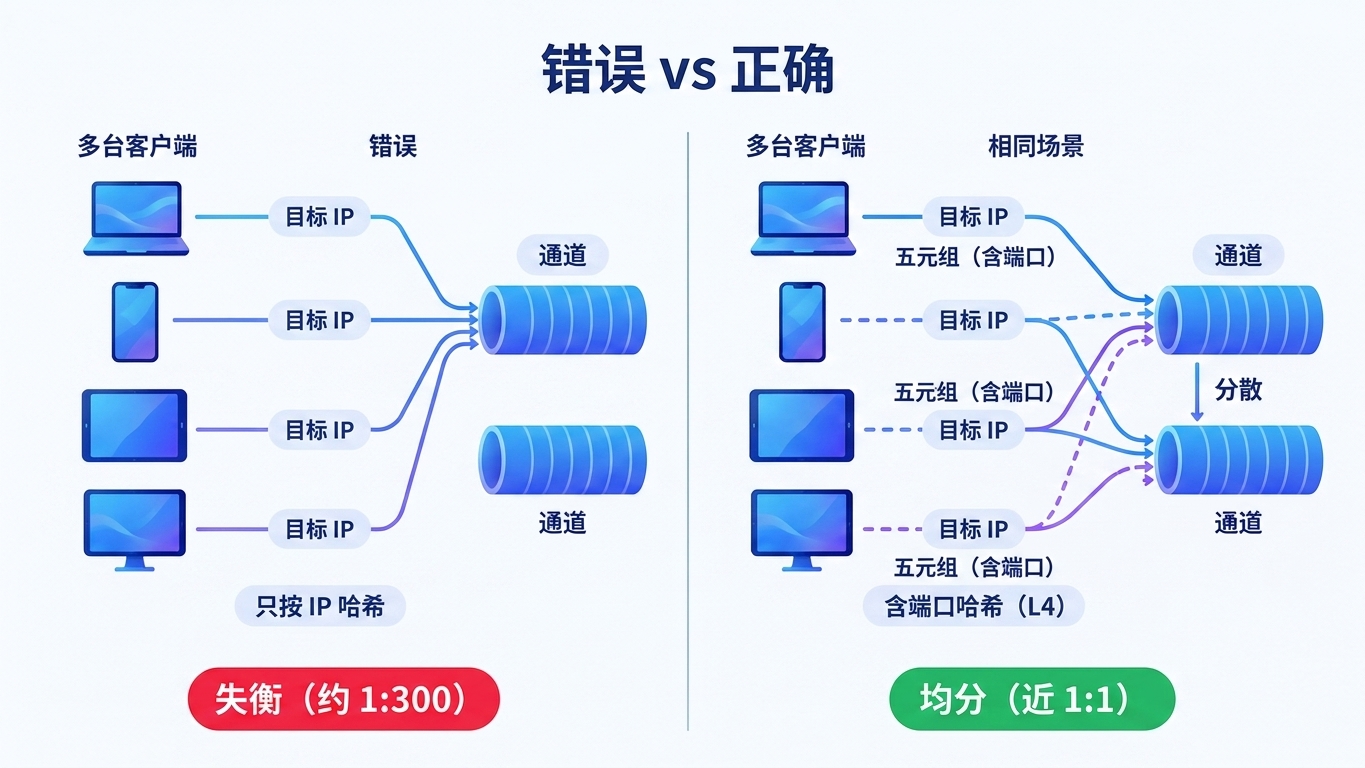
(左:只按 IP 哈希导致一腿失衡;右:含端口哈希(L4)后连接近 1:1 均分)
路径二:终端形态(聚合代理 + TUN)
解决「一台机器,如何吃掉多份会话带宽」:聚合代理(如 mihomo 的 load-balance 出站组)为每条新建连接选一个出站(round-robin 逐连接轮流或按规则哈希),每个出站对应一条会话——本机会话用「直连 + 接口绑定」表达,远端会话用「指向另一台已认证设备上转发器的 SOCKS5 出站」表达。TUN 模式把全系统流量收进虚拟网卡,应用只看得到一个出口。出站存活探测自动跳过失效腿,聚合可以从 K 腿平滑降级到 K-1、K-2 腿而不整体断网。
两条路径可以叠加:网关先把网内几条会话聚成「一个出口」,聚合代理再把该出口当作一条腿与本机会话合并——多级汇聚得到更多腿。
五、真正难的是健壮性
带宽翻倍听着爽,但聚合系统的收益只在「会话持续在线、桶始终满额」时才成立。实际跑起来,会话会静默回收、会被变动牵连清理、会被门户操作误删绑定——任何一环失效都会让聚合悄悄退化成单会话,而用户毫无感知。「健壮性 > 带宽」是这次研究最痛的一条结论。
故障模式清单(简化)
| 环节 | 典型症状 | 处置方向 |
|---|---|---|
| 会话被静默回收(饿死) | 网关 / DHCP 正常,数据面丢包 100% | keepalive 保活,打断饿死回路 |
| 会话被「变动牵连」清理 | 自己没动却掉线(同端口非豁免会话被清) | 减少变动;单点重新接入 |
| 真身设备重新上线顶替克隆会话 | 克隆桶丢包且无法恢复 | 识别后停用,勿反复重试 |
| DHCP 被拒 / 端口进入冷却 | 连 IP 都拿不到,网关 ARP 静默 | 长冷却(≥30 分钟)或物理断电重启 |
| 无感绑定被静默删除 | 桶丢包、网关通、白名单条目消失 | 白名单基线巡检,告警优先而非自动恢复 |
| 代理先于上游就绪启动 | 腿失效 auto-detect 失败,聚合退化 | 延迟启动 + 就绪探测 |
| 单腿劣化被健康检查掩盖 | 某条腿丢包 30~60%,单次探活仍能通过,它继续吃 1/N 流量,整体延迟被拖高 | 腿级降级:连续多轮采样丢包率 → 摘腿;恢复达标 → 放回 |
| 宿主机代理残留(探活被带偏) | 桶其实是通的,探活却一律 000 → 被误判丢包甚至触发摘腿 |
探活子进程剥离代理环境变量;走系统代理而非 TUN 的用户,停聚合后要清掉代理设置 |
两条最重要的经验:
- 表象相同、诱因不同:「网关通 + 数据面拦」既可能是会话被清、同账号互斥竞争,也可能是绑定被删——动手之前必须先分类,误操作会自我制造新的变动;
- 任何会话变动都是端口级成本:重认证、开关接口、换 MAC 会牵连同端口的其他会话。变动要「规划成一批、一次做完、长期冻结」,禁止试错循环。
四个关键工程
keepalive(防饿死)。 全量 TUN 接管后,某条直连腿可能分配不到流量 → 会话长期零流量 → 被网络侧按生命周期回收 → 更分不到流量,形成饿死循环。
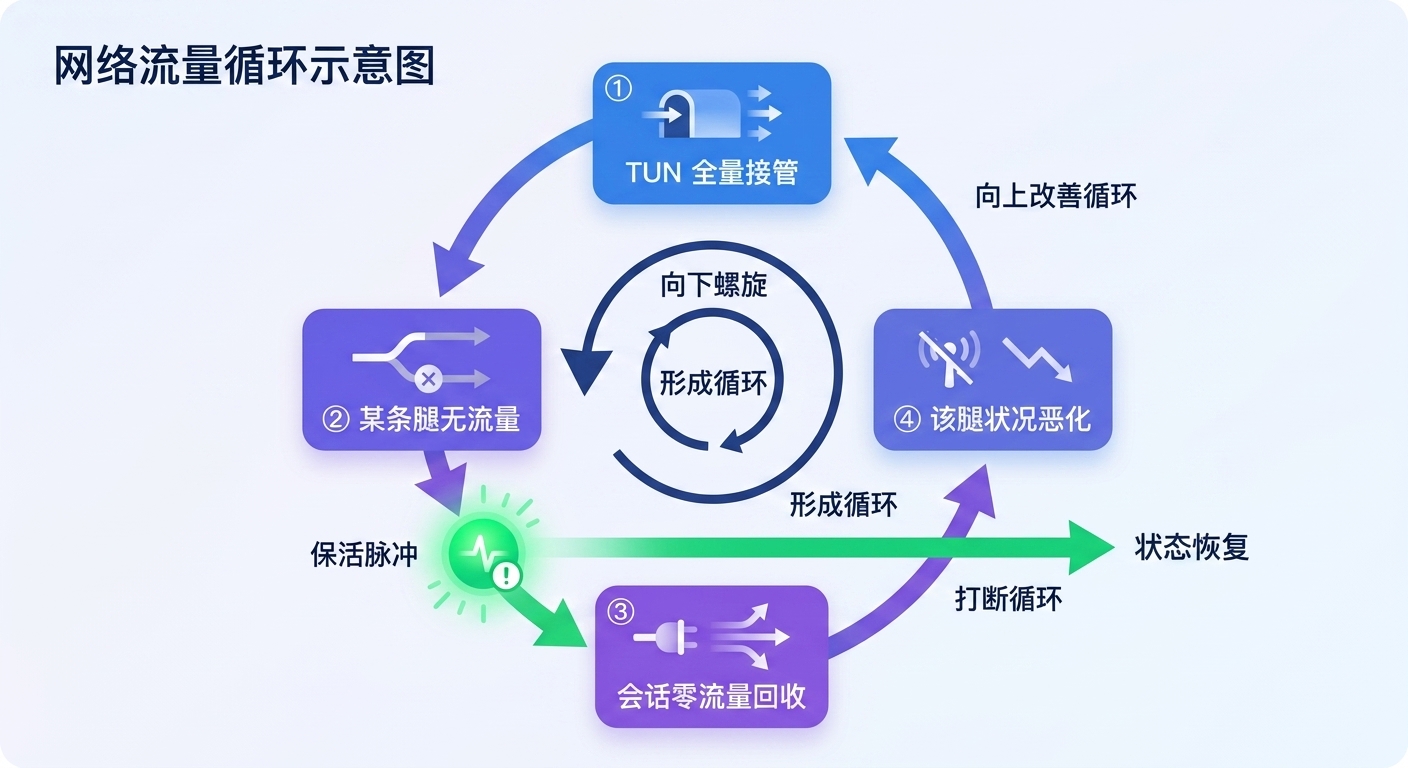
(饿死回路:无流量 → 被回收 → 更无流量;绿色标记为保活打断点)
对策是源绑定探测:明确指定探活对象(从该会话的源地址、对应接口发出探测,而不是随便 ping 一个网关),周期性为会话建立最小活性。最优雅的实践是「探测即保活」——每 2 分钟一轮的状态采样本身构成保活流量,把观测与维持合并成一份开销。
断线自愈(冷却纪律)。 恢复流程是「探测 → 分类 → 冷却 → 单点重连 → 复验」。
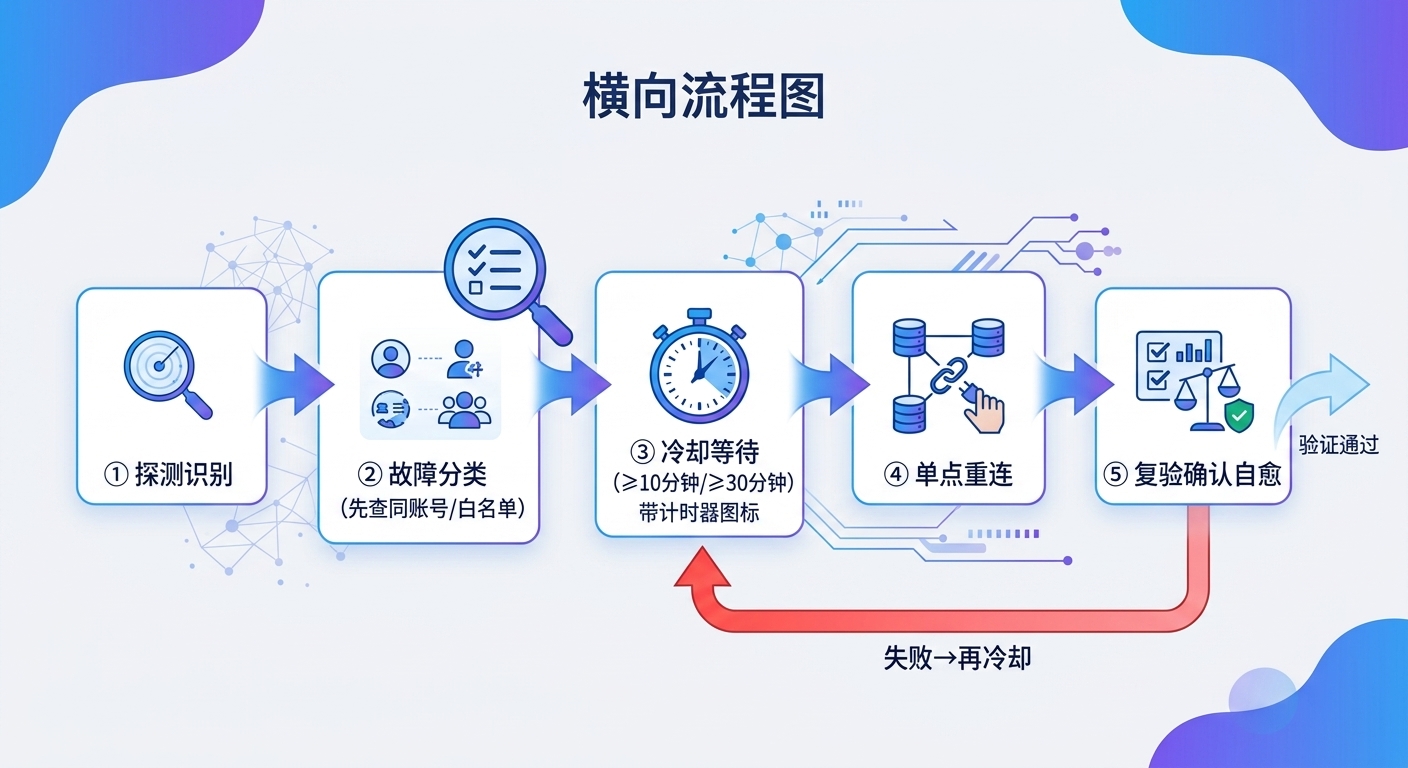
(自愈流程:探测 → 分类 → 冷却 → 单点重连 → 复验,失败则返回冷却)
铁律:变动间隔 ≥10 分钟;失败冷却 ≥30 分钟且冷却期零操作、只读轮询;配置原子化(一次写完生效,只触发一次接口事件);只对坏掉的那条腿单点重新接入(绝不全家 network restart,那会牵连所有会话)。认证类会话无法脚本化重认证,自动检测到失效后提示人工到认证页完成一次手动认证——这是全链路唯一的人工步骤。
白名单基线巡检(防不可逆损坏)。 门户的「下线」操作有两种形态:纯断会话(白名单保留,可恢复)和解绑 + 断会话(白名单条目被删除,不可逆)。掉线表象区分不了二者,而绑定被删是唯一不能用自动重连修复的故障。所以定期(远低于探活频率)拉取白名单快照做 diff,条目消失即产生事件告警,交给人工决策——告警优先,不做自动恢复。
分流熔断(腿级降级)。 断线自愈处理的是「腿完全不通」,而更隐蔽的一类是「腿还在,只是劣化了」:一条丢包 40% 的腿仍有约 60% 的概率通过单次健康检查,于是它继续吃 1/N 的流量,每一次分到它的请求都有概率重传或超时,整体延迟被拖高,而面板上它还显示「在线」。健康检查管「完全不通」,熔断管「通但丢包严重」,两者互补、不能互相替代。
判定不只看单次,而是看连续多轮:按桶每轮探测 N 次算出丢包率,连续 2 轮 ≥50% 就隔离该腿,连续 3 轮 ≤10% 再放回,中间值不动计数(避免抖动被累计成「坏」或「好」)。三条护栏缺一不可:
- 单轮抖动不误判:任何一轮达标就把「连续不合格」计数清零;
- 不允许摘到空:活跃腿数必须始终大于
keep_min(默认 1)——全摘等于把聚合出口打死; - 失败即回滚:摘腿 / 放腿的动作没真正执行成功(命令没配、非 0 退出、超时)就不记录为「已隔离」,界面状态必须等于实际拓扑,否则就是自欺(「面板说摘了、腿上还挂着」)。
执行上遵循「判定与动手分离」:判定逻辑是通用的,而怎么摘腿是环境相关的(改 provider 文件并热更新?调管理面 API?重启上游?),所以工具只做判定与编排,真正的动作走你自己配置的命令;没有可用手段时留空即可——熔断仍会采样并在界面显示丢包率,只是不真的摘腿。此外还有手动降级:正在换设备、室友要打游戏、临时排障时,把桶标记为停用即可(不探测、不动作、界面置灰,配置仍在,恢复只改一个布尔值),停用集合与熔断摘除集合取并集,两条路径互不干扰。
另外,夜间定时断电的环境下还需要「优雅关机链 + 开机自愈链」:断电前先让路由器 sync 刷盘再关机;开机后按「拉起虚拟机 → 等管理口就绪 → 拉各会话接口(无感免密自动恢复)→ 等代理上游端口监听 → 再启动聚合 → 核对各腿状态」的顺序自动恢复,实现无人值守。
六、落地:先自查,再配方,然后用控制台管起来
原理跑通之后,真正让人少走弯路的是三样工程化配套:先判断适不适用、用一个账号做出最小配方、把多桶管起来。
1. 先自查:这套东西适不适用
它不是「装上就能用」的通用工具——它依赖你所在网络的认证模型。动手前建议先确认三条必要前提:
- 物理链路够宽:推荐有线以太网(或多网卡)。只有一张无线网卡时,多个会话挤在同一空口上,合并通常没有收益、甚至更慢;
- 账号支持多并发,且限速按会话独立计量:这是等效带宽叠加的唯一前提——若限速按账号总量计算,多开会话只是互相抢同一份额度,整套方案失去意义;
- 能实测确认自己校园网的实际情况:认证形态、限速粒度、会话上限、下线判定语义都因学校而异,必须先实测,不能照抄任何人的结论。
反过来说,遇到下面这些情况就别浪费时间:限速按账号总量计、学校明确禁止多设备在线、只有一张无线网卡且无法走有线、校园网本身就是共享带宽池而没有单会话限速。
结论:先花半小时把确认清单跑一遍(认证方式 / 限速粒度 / 并发上限 / 会话终结语义 / 出口形态),再决定要不要投入时间。
2. 最小配方:只用自己的一个账号,做出「双桶」
想复现又不想碰别人的账号与设备?仓库里给了一条最小路径——单账号双桶:
- 桶 1(直连本体):你的电脑 / 软路由直插墙口,就是你账号的正常在线会话;
- 桶 2(同账号第二桶):把你自己账号白名单里第二台真实离线设备的标识,克隆到一台轻量软路由(如 OpenWrt 虚拟机)上,无感免密放行,形成第二条独立限速桶;
- 合并:宿主侧用聚合代理把「直连」与「经软路由 SOCKS 的第二桶」按连接分发——两条会话同属一个账号,出口侧合成「一台设备」的体验。
前提是你的账号有 ≥2 个并发名额、墙口物理链路 ≥ 2 × 单会话带宽,并且先裸连认证好两条会话再开 TUN。这套形态不涉及他人账号、不冒用他人设备,只在你自己已付费的套餐名额内并发,是最容易自查合规边界的入门路径(也是三桶 / 四桶的起点)。
3. 多桶聚合控制台:从「能跑」到「好管」
搭好之后,日常要看状态、要续连、要测速,逐个 SSH 太累。于是有了一个「托盘 + 全操控界面」的桌面控制台:
- 一眼看状态:总览卡片(在线桶数、门户劫持、白名单、真机判定、聚合腿组、数据新鲜度)+ 每桶状态表 + 健康走势图(近 240 次采样滚动记录,颜色区分在线 / 中间态 / 离线);
- 点按钮做操作:每桶探活 / 真机判定 / 续连 / 单桶测速,聚合出口重启与代理开关,计划任务启停,一键测速;
- 分流熔断:按桶采样丢包率,连续超阈值的腿自动摘除、连续达标自动放回(就是上一节那套判定);
- 桶可停用 / 启用:临时停掉某条腿不必删配置——停用后不探测、不动作、界面置灰;
- 配置不用手改 JSON:schema 驱动的配置编辑器,保存前校验、自动备份、就地热更新;
- 只读 + 调度:它不实现任何认证逻辑,所有动作都执行你自己配置的命令;环境相关的一切(桶、出口、脚本、账号)都落在本地私有配置文件里,不随仓库提交;
- 生命周期总开关:界面起则拉起服务链,界面退则全链停,配套任务以心跳文件为门控(界面崩了心跳消失,巡检自动停手);
- 账号凭据独立托管:密码走系统凭据库(Windows DPAPI / 系统钥匙串),明文只存在于进程内存,脚本在真正调用接口那一刻才取用,不落日志;
- 自带回归:端口校验与「摘腿 / 放腿」全行为的自检脚本可重复运行,改动不会悄悄退化。
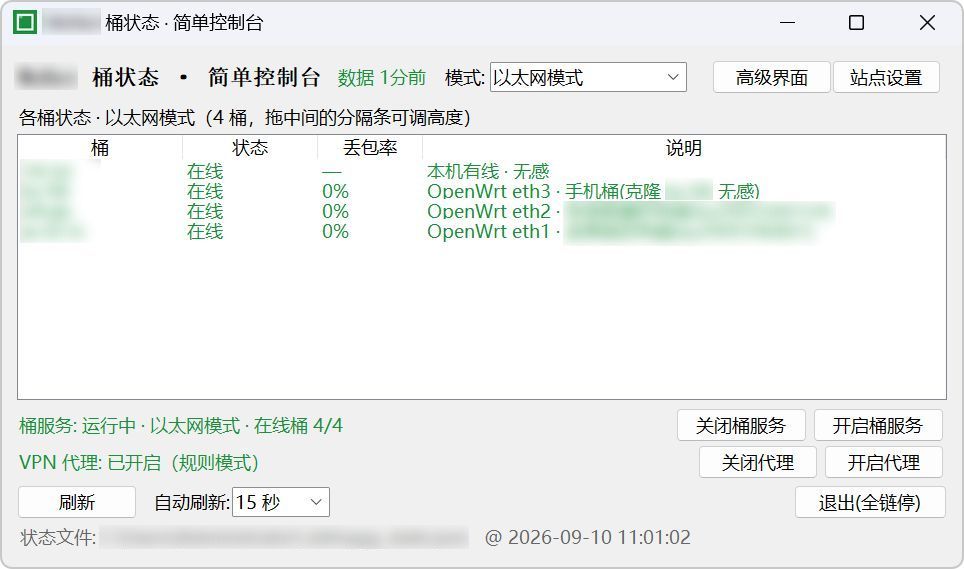
(简单控制台:每桶在线状态、丢包率与说明一目了然,顶部给出桶服务状态与代理开关)
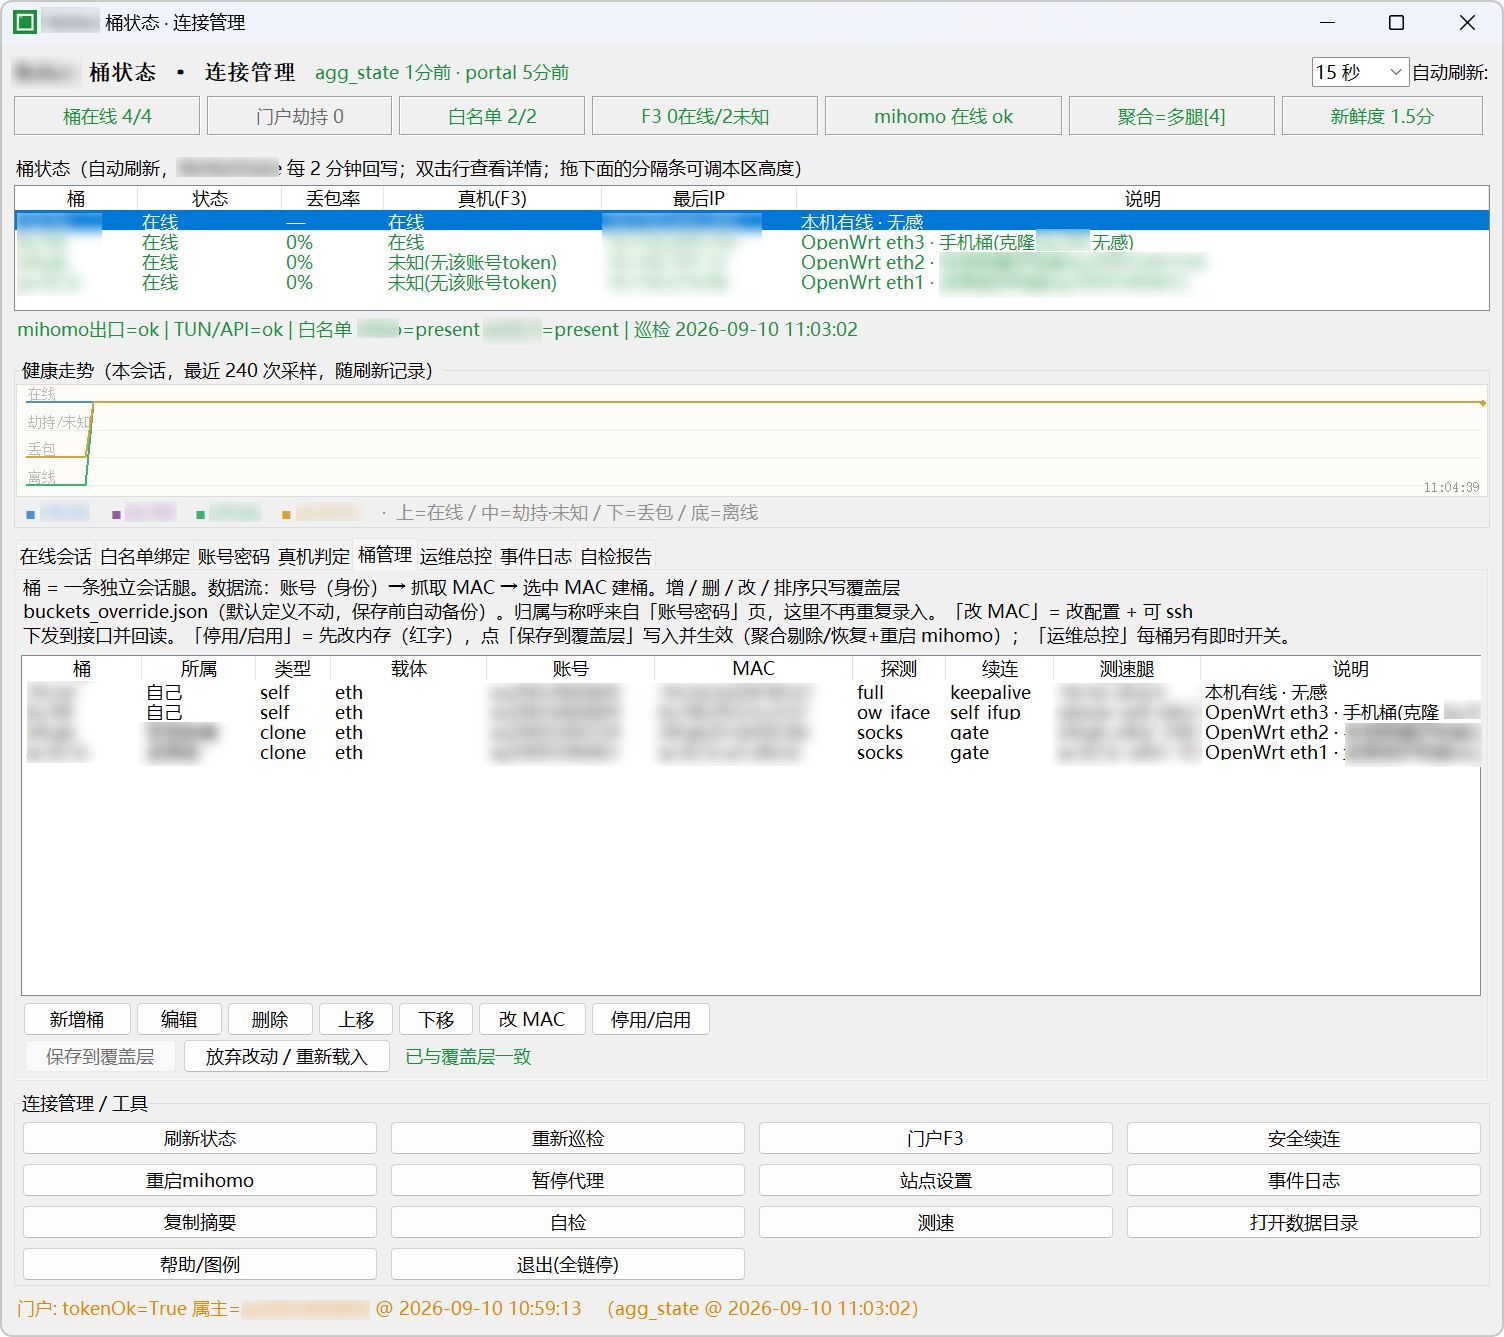
(高级界面:总览卡片 + 健康走势图 + 每桶状态与操作入口;图中为演示数据)
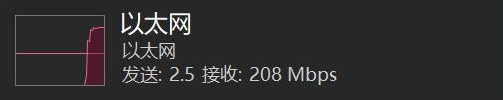
(多腿同时在线时,出口链路接收速率进入两百 Mbps 档位,高于单会话上限)
4. 一句提醒:让编码 Agent 带你搭
这个活是「多环节 + 强环境相关」的:认证行为观察 → 会话分发 → multipath / 聚合出口调参 → 保活与巡检 → 控制台配置,每一步都取决于你自己网络的实际行为,没有标准答案。所以我更推荐用编码 Agent 辅助部署与排障,而不是纯手工照抄文档——仓库 README 里备了一份可直接复制的提示词,核心约束是:先提问确认环境、每步说清要改什么与风险、每步都要有可观测的验证方式、凭据不落明文、不可逆操作先停下来确认影响面。
七、顺带的安全发现与责任边界
研究过程中也观察到一些可作防御参考的通用风险(详情与修复建议见开源文档):
- 无感认证「绑定要凭据、放行只看 MAC 单因子」:绑定动作受保护,但放行侧是单因子,且设备标识可被伪造;
- 查询类接口往往不校验请求者与被查数据的归属关系;「下线 / 解绑」类弱校验操作与「纯下线」的后果差异很大——解绑会级联断会话且不可逆;
- 对普通用户更实际的教训:别在设备管理页随手点「下线」,你可能把一个不可逆的解绑操作发出去了。
这些内容全部以防御视角整理,不包含任何利用细节、接口形态或真实环境信息。发现过程仅在自有权属 / 获授权的账号与设备上完成,并按负责任披露的路径处理。这里明确边界:
- 本研究仅基于本人拥有使用权 / 已获授权的账号与设备,全部为主动测量,未对任何生产设备施压、未污染任何他人数据;
- 本文不提供任何绕过付费 / 限速条款的操作指引;在他人账号、设备或网络上规模化利用此类机制(枚举、冒用、干扰)违反法律与网络管理规定,请务必不要尝试。
八、开源:怎么把研究发出去而不惹麻烦
这是研究里我最重视的一环。原始材料里有大量真实标识(MAC、IP、账号、精确速率、厂商实现),公开出去的仓库必须只承载方法论与可复现逻辑,不承载任何可识别个人 / 设备 / 网络的原始标识。为此专门写了《脱敏与贡献规范》文档:
- 占位符规范:所有敏感值统一用
<MAC_A>、<网关IP>、<会话ID>这类占位符表达,同一实体全文使用同一占位符; - 数据表述规则:精确速率一律改写为相对倍数 / 量级区间(如「双会话约为单会话的 1.7~1.9 倍」「平台值处于数十 Mbps 档位」);
- 黑名单词条:厂商品牌、代理服务等敏感词全仓封杀;
- 提交前自查:一条
rg正则命令扫全仓(MAC / IP / 密钥 / 口令 / 黑名单词),命中即人工复核,PR 描述附一行自查结果; - 红线清单:真实 MAC、IP、账号、精确测量值、他人数据、本地目录路径等九类内容在任何形式下禁止提交;已进历史的一律按「改写历史 + 轮换凭据」处理;
- 演示截图:控制台截图上传前逐张打码(品牌名、本机绝对路径、账号、设备标识、地址),并标注「图中数值为演示示例值」。
仓库结构(MIT 许可):
docs/
  00_脱敏与贡献规范.md     贡献者保密红线、占位符规范与自查流程
  01_认证与多会话原理.md   无感认证、设备白名单、多会话并存模型
  02_多设备网速合并原理.md 多会话出口合并、L4 哈希分发与瓶颈分析(核心)
  03_限速机制与等效带宽.md 单会话限速模型、等效带宽推导与实测方法论
  04_健壮性设计.md         keepalive、断线自愈、腿级降级、白名单巡检、断电自愈链
templates/                全占位符化的可复用配置模板
experiments/              聚合是否生效的验证方法与验收判定标准
recipes/
  single_account_dual_bucket/  配方:单账号双桶(只用一个账号的最小可照做方案)
tools/
  bucket_console/         多桶聚合控制台(含分流熔断 leg_ctl.py 与自检回归)
assets/screenshots/       控制台功能演示图(已打码脱敏)
仓库地址:github.com/huonanwholovecomputer/campus-bandwidth-aggregation
九、复盘与后续
方法论层面最大的收获是那条研究链:观察 → 假设 → 验证 → 建模 → 工程 → 健壮化。每一步都逼自己先写「可被证伪的判据」再动手——「限速按会话生效」不是靠感觉,而是靠 6 条证据交叉验证;「聚合生效」不是靠单连接测速,而是靠多腿同时有吞吐 + 并发合计逼近 N×C。
工程化层面的收获是另一条:从「能跑」到「好管」,中间隔着一整套运维约束——把「判定」与「动手」分离(工具只做判定与编排,动作交给用户自己配置的命令)、把界面状态与真实拓扑强制对齐(命令没成功就不许显示「已隔离」)、把生命周期收成一个总开关(界面起则拉起服务链、界面退则全链停、配套任务以心跳文件门控)。这些约束看着繁琐,但正是它们让「无人值守连续跑」这件事成立。
踩坑清单(希望后来者少走弯路):
- CDN 单连接限流约为会话上限的 1/3,用它判断「网络限速太低」是误判;
- L3 哈希「假平坦」:配置了 multipath 却没提速,先查哈希策略是否含端口;
- 峰值(PIR 突发)不能用于容量规划,以平台稳定值为准;
- 单连接测速永远显示「没聚合」,验收必须多连接并发 + 逐会话观测;
- 测速值忽高忽低,先怀疑「测试期间动过接口」——接口变动是有惩罚窗口的;
- 掉线先分类再动手:查同账号其他会话是否在线、查白名单快照,别把正常竞争当故障反复重连;
- 探活一律返回
000不一定是腿坏了——先看是不是宿主机的系统代理残留把探测带偏了(聚合停掉后端口没人监听); - 单腿丢包 30~60% 时「在线」是假象:健康检查过得去,但它会持续吃掉 1/N 的流量,该用腿级熔断摘掉,而不是整链重启。
后续计划:补充更多会话组合的长期稳定性数据;把配方与控制台打磨得更通用(适配更多聚合出口形态与摘腿手段);继续摸清「认证类会话」自动化的可行性边界。
如果有同好也在做类似研究,欢迎交流;也欢迎给开源仓库提 PR——但记得,先读一遍《脱敏与贡献规范》。